AzureのText to speech avatarでAIアバターを作る勘所|利用の制限と使いどころ
AIアバターは「作れるかどうか」ではなく、「どこで詰まるか」を先に知っているかどうかで差がつく段階に入りました。
本記事は、Azure の AI アバター機能である Text to speech avatar を実際に動かし、公式ドキュメントのとおりに進めても止まる箇所・その回避策・そして向く用途と向かない用途を整理したものです。
弊社は自社の会社紹介動画を制作する過程で、この機能を実際に叩いて検証しました。結果として自社動画の本番には別の方式を採用していますが、その検証の過程で分かったことは、これから AI アバターの導入を検討される企業にとって、そのまま判断材料になるものでした。検索で見つかる紹介記事の多くは「Azure でも AI アバターが作れます」で終わっており、実際に手を動かしたときに止まる場所までは書かれていません。本記事はそこを埋めることを目的としています。
目次
株式会社ロクシアシステムズは、福岡と東京を拠点に、全国のお客様へ Microsoft 365・Azure の導入支援と、AIの業務活用(AIプライベート)の支援を提供しているIT企業です。
AIアバターとは|Azureで作れるものの全体像
AIアバターとは、人物の映像を合成し、入力したテキストや音声に合わせて喋らせる仕組みの総称です。デジタルヒューマン、バーチャルヒューマンとも呼ばれます。実在の人物を撮影する必要がないため、原稿を差し替えるだけで何度でも作り直せること、多言語へ展開しやすいことが特徴です。
Azure でこれを担うのが Azure AI Speech の Text to speech avatar です。Microsoft Foundry の画面からコードを書かずに試すこともできますし、API から呼び出してアプリケーションに組み込むこともできます。音声は Azure の音声合成がそのまま使われるため、対応言語は音声合成の対応言語と同じです。
最初に押さえるべきなのは、Azure の AI アバターが二つの系統に分かれていることです。この二つは解像度もできることも違い、あとから乗り換えるのが簡単ではありません。
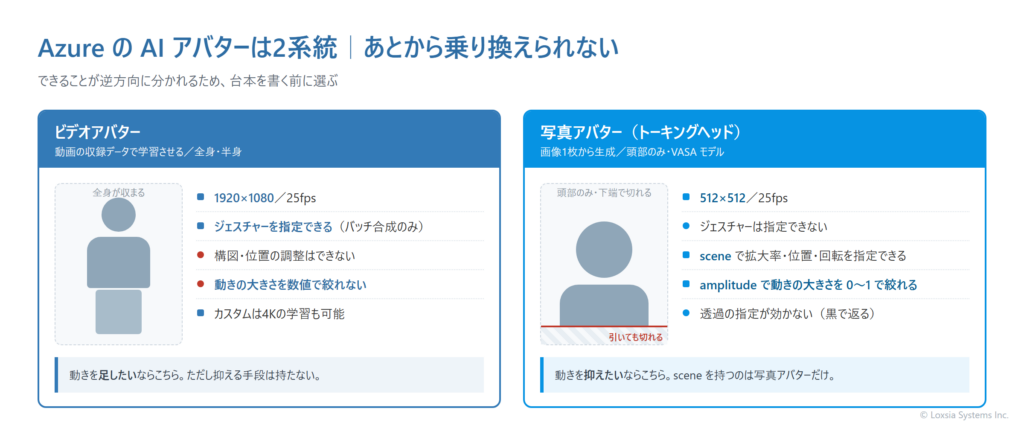
仕様を並べると次のようになります。
| 項目 | ビデオアバター | 写真アバター(トーキングヘッド) |
|---|---|---|
| 作り方 | 動画の収録データで学習させる | 画像1枚から生成する |
| 写る範囲 | 全身・半身 | 頭部のみ |
| 解像度 | 1920×1080(カスタムは4Kの学習も可) | 512×512 |
| フレームレート | 25fps | 25fps |
| ジェスチャー | 指定できる(バッチ合成のみ) | 指定できない |
| 構図・動きの調整 | できない | scene で拡大率・位置・回転・動きの大きさを指定できる |
| 駆動モデル | ニューラルネットワークモデル | Microsoft の VASA モデル(vasa-1) |
そしてそれぞれに、Microsoft が用意した標準アバターと、自社で用意するカスタムアバターがあります。標準アバターは申請なしですぐ使えますが、後述するとおり「ずっと同じものが使える」保証はありません。カスタムアバターは限定アクセスの申請が必要で、ここが実務上いちばん高い壁になります。
最初に効いてくる制約はリージョン|Japan East では動かない
機能の話に入る前に、多くの案件で最初に効いてくる制約があります。Text to speech avatar は Japan East・Japan West のいずれにも対応していません。音声合成そのものは日本リージョンで動きますが、アバター機能だけは対象外です。
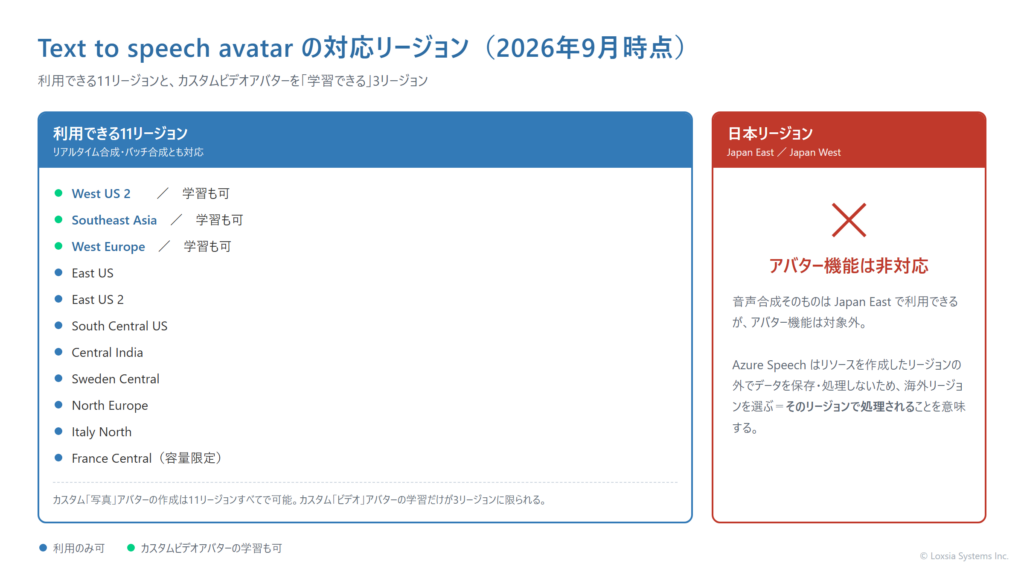
2026年9月時点で対応しているのは次の11リージョンです。同じ「対応」でも、使うだけなのか、カスタムアバターを学習させるのかで、選べる範囲がさらに変わります。
| リージョン | リアルタイム合成 | バッチ合成 | カスタムビデオ アバターの学習 | カスタム写真 アバターの作成 |
|---|---|---|---|---|
| West US 2 | 〇 | 〇 | 〇 | 〇 |
| Southeast Asia | 〇 | 〇 | 〇 | 〇 |
| West Europe | 〇 | 〇 | 〇 | 〇 |
| East US | 〇 | 〇 | ✕ | 〇 |
| East US 2 | 〇 | 〇 | ✕ | 〇 |
| South Central US | 〇 | 〇 | ✕ | 〇 |
| Central India | 〇 | 〇 | ✕ | 〇 |
| Sweden Central | 〇 | 〇 | ✕ | 〇 |
| North Europe | 〇 | 〇 | ✕ | 〇 |
| Italy North | 〇 | 〇 | ✕ | 〇 |
| France Central(容量限定) | 〇 | 〇 | ✕ | 〇 |
| Japan East / Japan West | ✕ | ✕ | ✕ | ✕ |
ここで見落とされがちなのが、カスタムビデオアバターの学習ができるのは West US 2・Southeast Asia・West Europe の3リージョンだけだという点です。「対応リージョン一覧に載っているから大丈夫」と読むと、学習の段になって使えないことが分かります。
そしてこの制約は、単に「遠いリージョンを使う」以上の意味を持ちます。Microsoft は Azure Speech について、データはリソースを作成したリージョンの外では保存も処理もされないと明記しています。裏を返せば、East US 2 にリソースを作ってアバターを生成するということは、その原稿と生成物が米国で処理されるということです。
要点
「データを国内に留めること」を要件に掲げている案件では、Azure の AI アバターは現時点で要件を満たせません。ここは機能の優劣ではなく提供リージョンの問題なので、工夫で回避することはできません。検討の入口で必ず確認すべき項目です。
なお、データの置き場所そのものを判断軸にする考え方については、ソブリンクラウドとデータ主権の解説もあわせてご覧ください。
実装の入口|バッチ合成APIと、エンドポイントの落とし穴
動画ファイルとして書き出す場合は、バッチ合成APIを使います。ジョブを投げて、状態をポーリングし、成功したら動画をダウンロードする、という非同期の流れです。
| 操作 | メソッド | パス |
|---|---|---|
| ジョブ作成 | PUT | avatar/batchsyntheses/{SynthesisId}?api-version=2024-08-01 |
| 状態取得 | GET | avatar/batchsyntheses/{SynthesisId}?api-version=2024-08-01 |
| 一覧 | GET | avatar/batchsyntheses/?api-version=2024-08-01 |
| 削除 | DELETE | avatar/batchsyntheses/{SynthesisId}?api-version=2024-08-01 |
エンドポイントはリソース名ではなくカスタムサブドメイン
ドキュメントのサンプルは https://YourResourceName.cognitiveservices.azure.com/ という形で書かれているため、リソース名からURLを組み立てたくなります。しかし実際に払い出されるのはカスタムサブドメインで、リソース名にランダムな接尾辞が付いた別の文字列になっていることがあります。弊社はここで名前解決に失敗しました。推測せず、次のコマンドで実際の値を引いてください。
az cognitiveservices account show \
  --name <リソース名> --resource-group <リソースグループ> \
  --query properties.endpoint -o tsv
ジョブIDと、覚えておきたい上限値
ジョブIDは自分で決めます。3〜64文字で、英数字とハイフン・アンダースコアが使え、先頭と末尾は英数字でなければなりません。同じリソース内で重複はできないため、「同じ原稿を設定だけ変えて作り直す」ときに衝突します。弊社は秒単位の時刻と設定のハッシュをIDに含めることで回避しました。
| 項目 | 値 |
|---|---|
| 出力動画の最大長 | 20分 |
| 1リソースあたりの同時実行ジョブ数 | 200 |
| リクエストJSONの最大サイズ | 500KB |
| ジョブ履歴の保持期間 | 31日、または timeToLiveInHours(最大744時間)の短いほう |
| 1ジョブで生成できる動画数 | 最大1,000(複数出力にはBlobコンテナの指定が必要) |
保持期間は見落としやすい項目です。生成物は放っておくと消えます。成功したらすぐ自社側へダウンロードして保管する、という前提で組んでください。また、出力先に自前のストレージアカウントを指定する場合、そのアカウントはすべてのネットワークからのアクセスを許可している必要があります。ネットワーク制限をかけたストレージはサポートされていないため、閉域寄りの構成を想定している場合はここも確認が要ります。
写真アバターで実際に詰まった2点
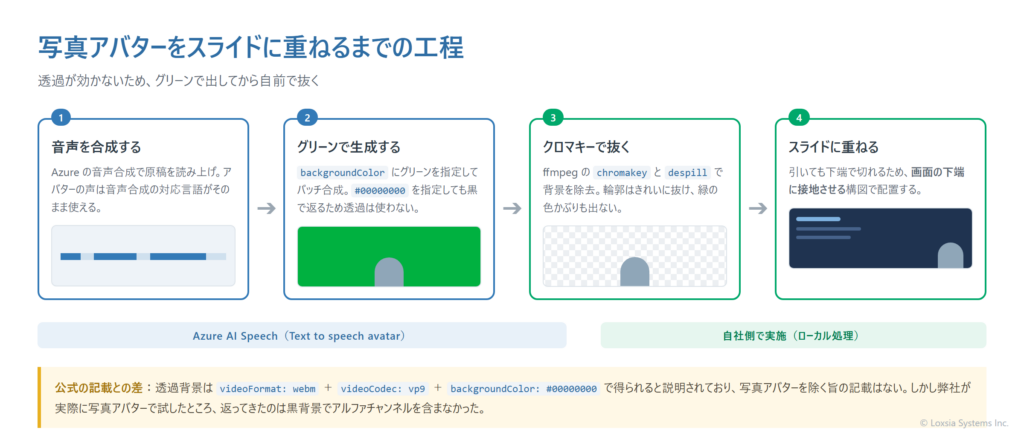
ここからが、実際に手を動かさないと分からない部分です。弊社はスライドの上にアバターを重ねる構成を想定していたため、背景を透過させたうえで位置と大きさを調整する必要がありました。どちらも公式ドキュメントには手段が書かれています。しかし写真アバターでは、そのとおりにいきませんでした。
① 透過の指定が効かず、黒背景で返ってくる
公式ドキュメントは、透過背景の動画を作るには次の3つを指定すると説明しています。
videoFormatをwebmにするvideoCodecをvp9にする(アルファチャンネルを持てるのは VP9 だけ)backgroundColorを#00000000にする
この説明に写真アバターを除く旨の記載はなく、写真アバターのバッチ合成も VP9 に対応していると明記されています。ところが弊社が実際にこの組み合わせで写真アバターを生成したところ、返ってきたのは黒背景の動画で、アルファチャンネルは含まれていませんでした。ffprobe で確認すると pix_fmt は yuv420p、alphaextract も失敗します。透過の仕様はビデオアバター側のものと考えるのが実態に近そうです。
回避策はあります。背景をグリーンで塗って出力し、あとからクロマキーで抜く方法です。弊社はこれで問題なく合成できました。抜いた輪郭はきれいで、緑の色かぶりも出ませんでした。
"avatarConfig": {
  "talkingAvatarCharacter": "<アバター名>",
  "photoAvatarBaseModel": "vasa-1",
  "videoFormat": "webm",
  "videoCodec": "vp9",
  "backgroundColor": "#00B140FF"
}
ffmpeg -i avatar.webm \
-vf "chromakey=0x00B140:0.12:0.05,despill=type=green" \
-c:v vp9 out.webmドキュメントの表記ゆれに注意
透過背景の説明表では properties.videoFormat という書き方をしていますが、プロパティ一覧では avatarConfig.videoFormat です。実際に効くのは avatarConfig 配下です。ここを取り違えると、指定したつもりで既定値のまま生成され続けます。
② 引いて全身を収めることはできない
写真アバターでは scene.zoom で拡大率を指定できます。「1.0 が100%」とだけ書かれているので、値を下げれば引いた画になり、被写体全体が枠に収まると考えたくなります。
実際には、zoom をどれだけ下げても被写体はフレームの下端で必ず切れます。上と左右には余白ができますが、下だけは切れたままです。写真アバターはそもそも頭部のみの表現なので、切り抜き素材のように背景から完全に浮かせることはできない、と理解するのが正確です。
したがってスライドに重ねるなら、アバターを画面の下端に接地させる構図で組むのが前提になります。弊社はこの前提で zoom 0.70 ・ amplitude 0.3 を採用し、合成時に下マージンをゼロにして画面右下に配置しました。
動きを抑えたいなら写真アバター一択|amplitudeという数値
企業の説明動画でAIアバターを使うとき、多くの場合に出てくる要望が「もっと落ち着かせてほしい」です。身振りが大きい、表情が動きすぎる、視線が泳ぐ。この種の要望に数値で応えられるかどうかは、サービスを選ぶうえで意外に大きな差になります。
Azure では、写真アバターに限り avatarConfig.scene が使えます。
| パラメータ | 範囲 | 意味 |
|---|---|---|
zoom | 0より大きい値 | 拡大率。1.0が100% |
positionX / positionY | -1 〜 1 | 水平・垂直方向の位置。0が中央 |
rotationX / Y / Z | -π 〜 π | 各軸まわりの回転(ラジアン) |
amplitude | 0より大きく1以下 | 動きの大きさ。1.0が全振幅で、下げるほど動きが小さくなる |
公式ドキュメントは scene について「写真アバターでのみ使用でき、ビデオアバターはサポートしない」と明記しています。つまり全身のビデオアバターを選んだ時点で、動きの大きさを数値で絞る手段はなくなります。
逆方向の制約もあります。ジェスチャーを指定できるのはビデオアバターだけで、しかもバッチ合成に限られます(リアルタイム合成では使えません)。「手を挙げる」「数字を示す」といった動作をSSMLのブックマークで差し込めるのはビデオアバター側の強みです。
選び方の目安
動きを足したいならビデオアバター、動きを抑えたいなら写真アバター。この二択は後から入れ替えられません。台本を書く前に、映像で何をさせたいのかを決めておくほうが結果的に早く進みます。
なお、カスタムビデオアバターの学習時に音声も同時に作る「voice sync」を有効にした場合、合成時に useBuiltInVoice を true にするとジェスチャーも字幕も生成されなくなります。声をアバターに合わせる代わりに機能が減る、というトレードオフです。
標準アバターは「ずっと使える」とは限らない
これは実際に使い始める前に知っておいたほうがよい事実です。Microsoft が用意している全身の標準アバターには、実在の俳優をもとに作られているものが含まれます。俳優と Microsoft のライセンス契約が有効である限り使えるという位置づけで、公式ドキュメントにもそのように書かれています。
そして現に、全身アバターの一つである「Jeff」は2026年12月から提供終了になると明記されています。契約が満了したアバターは利用できなくなり、事前告知はされるものの、利用者は別の標準アバターに切り替えるか、カスタムアバターを作るか、システムが選んだ代替アバターを使い続けるかを選ぶことになります。
実務への影響
標準アバターを「自社サービスの顔」として前面に出す設計は、提供終了のリスクを抱えます。動画資産が多いほど作り直しの負担は大きくなります。継続的にブランドの顔として使う前提なら、最初からカスタムアバター(=限定アクセスの申請)を織り込むか、逆に「顔を固定しない」設計にしておくのが安全です。
一方、頭部のみのトーキングヘッド(写真アバター)は30体前後が用意されており、こちらは画像から生成されるタイプです。短尺の案内動画であれば、標準の写真アバターで十分に成立します。
カスタムアバターの壁|限定アクセスの実際
「自社の顔でAIアバターを作りたい」という要望は自然なものですが、Azure ではここに明確な壁があります。カスタムアバターは限定アクセス(Limited Access)機能で、登録して承認されなければ使えません。
そして適格条件が、公式ドキュメントに次のように書かれています。
Only customers managed by Microsoft, meaning those who are working directly with Microsoft account teams, are eligible for access.
(Microsoft が管理する顧客、すなわち Microsoft のアカウントチームと直接取引している顧客のみが、アクセスの対象になります)
これは技術要件ではなく取引形態の要件です。Microsoft の担当営業が付いている規模の企業でなければ、そもそも申請の土俵に乗らない可能性が高い、ということを意味します。この一文に触れている解説記事はほとんど見かけませんが、導入可否を左右する最も実用的な情報だと考えています。中堅・中小企業が検討する場合は、Microsoft のパートナーやディストリビューターを経由してアカウントチームに接続する道を先に探るのが現実的です。
申請が通った場合、作成手順は二系統に分かれます。
| 項目 | カスタムビデオアバター | カスタム写真アバター |
|---|---|---|
| 必要な素材 | 10分以上の動画収録 | 画像1枚 |
| 同意の取得 | 必須(本人が同意文を読む動画) | 実在人物の写真なら必須。「Create with AI」で生成した人物なら不要 |
| 同意動画の形式 | .mp4 または .mov/500MB未満/3秒より長く1分未満 | |
| 学習できるリージョン | West US 2・Southeast Asia・West Europe | 対応11リージョンすべて |
| デプロイ | 必要 | 不要(作成完了後すぐ利用可) |
カスタム写真アバターには「Create with AI」という経路があり、年齢・性別・エスニシティ・スタイルを指定して人物画像そのものを生成できます。この経路なら実在人物が存在しないため、同意動画の提出が不要になります。架空のキャラクターを立てたい場合はこちらが素直です。
元画像の条件と、変えられないこと
写真アバターの元画像には、公式に条件が示されています。頭部しか映らないため肩から上が写った画像がよく、顔は実在または仮想の人間らしく見える必要があります(目が極端に大きいなど、アニメ調の造形はサポートされません)。装飾品の多い画像は避け、頭部全体が正面を向いて、影や隠れた部分なく見えていることが求められます。
そして重要なのは、出来上がったアバターの見た目は変えられないことです。公式ドキュメントは「服装や髪型といったアバターモデルの外見をカスタマイズすることはサポートしない」と明記しています。同じ人物で複数のスタイルが必要なら、スタイルごとに学習データを用意し、それぞれ別のアバターモデルとして作る必要があります。
承認されたあとに続く「運用の義務」
カスタムアバターは、承認されたら自由に使えるようになる、というものではありません。Microsoft のサービス固有条項のもとで継続的な義務が発生します。これは機能ではなく運用要件として捉えるべき項目です。
- 合成であることの開示:アバターを配置する際、それが合成されたものであることを利用者に開示する
- フィードバック窓口の維持:利用者が問題を報告し、Microsoft に詳細を共有できる経路を用意する
- 承認された用途に限定:登録時に選択し Microsoft が承認したユースケースの範囲内でのみ使う
- タレントからの書面による許諾:アバターのもとになる人物から明示的な書面許諾を得たうえで、「音声・アバタータレント向けの開示文書」を事前に共有する
- 登録情報の再検証への対応:Microsoft は登録時に提出した情報の再確認を求めることがある
実務としては、動画の画面内やチャットのUIに「この映像はAIによる合成です」といった表記を常時出し、問い合わせ導線を用意しておく設計になります。弊社はAIが対外的に登場する場面では、これを社内ルールとして明文化しています。ゼロトラストや情報ガバナンスを扱う立場としても、後から発覚するほうが遥かに大きな損失になると考えているためです。
現状の限界|写真1枚から動かす方式の原理的な制約
ここまでは設定や手続きの話でしたが、最後に技術そのものの限界に触れておきます。
写真アバターは、画像1枚と音声から映像を生成します。顔の動きは指定されたものではなく、音声から推測されたものです。口の形は音に合わせて合理的に動きますが、表情・まばたき・頭の傾きといった要素は、モデルが「このあたりでこう動くだろう」と補っています。
これは Azure に限った話ではなく、写真1枚から人物を動かす方式に共通する性質です。弊社が複数のサービスを同一条件で比較した際にも、意図していない表情が混ざること、音声が硬いと表情も硬くなることが共通して見られました。動きを抑えるプロンプトを与えても出力がほとんど変わらないサービスもありました。Azure の amplitude は「動きの大きさ」を数値で絞れる点で扱いやすい部類ですが、それでも「何をするか」を指定しているわけではありません。
結果として、尺が長くなるほど不自然さが目に付きやすくなります。数十秒の案内であれば気にならないものが、数分の解説動画になると「人間らしさ」への期待値が上がり、わずかなズレが引っかかるようになります。現時点では、AIアバターは尺の短い用途に寄せるほうが成功しやすいと考えています。
向く用途・向かない用途
ここまでの制約を踏まえると、使いどころは比較的はっきりします。
| 用途 | 適性 | 理由 |
|---|---|---|
| 受付・案内の一次対応 | ◎ | 一回のやりとりが短く、動きを抑えた表現が自然に見える。Voice Live と組み合わせれば対話もできる |
| 多言語での同一案内 | ◎ | 原稿を差し替えるだけで展開できる。撮り直しが不要 |
| 短尺の製品紹介・操作案内 | 〇 | 30秒〜1分程度なら不自然さが出にくい |
| 社内向けの研修・手順動画 | 〇 | 更新頻度が高いほど、作り直せる利点が効く |
| 数分以上の解説動画 | △ | 尺が伸びるほど表情の不自然さが目立つ。スライド主体で顔を小さく扱うなら成立する |
| ブランドの顔としての継続運用 | △ | 標準アバターは提供終了の可能性がある。カスタムは限定アクセスの壁がある |
| データを国内に留める必要がある案件 | ✕ | 日本リージョンで提供されていない |
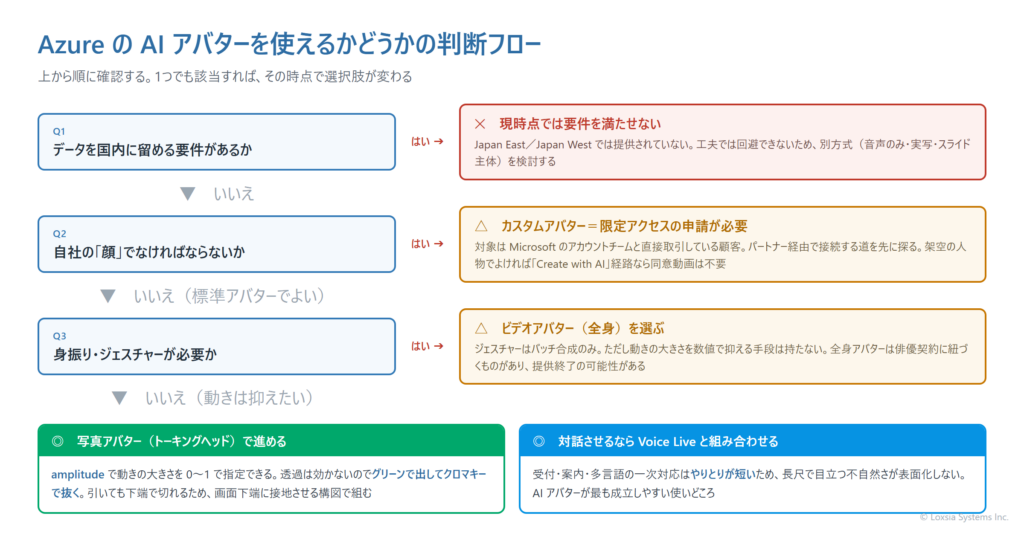
とくに相性がよいのは、リアルタイムの対話にアバターを載せる使い方です。Azure では Voice Live と組み合わせることで、音声で応答するAIエージェントに顔を持たせられます。受付、店頭案内、多言語での一次対応といった場面では、短いやりとりの繰り返しになるため、前述した「尺が伸びると不自然になる」問題が表面化しません。音声AIエージェント側の作り方については、Voice Live API の解説記事で詳しく扱っています。
では、AIアバターで実際に作るとどの程度のものになるのか。参考として、弊社がAIアバターで制作した会社紹介動画を掲載します。スライドを主体にして、アバターは画面の下端に接地させる——本記事で触れた構図をそのまま使っています。
弊社の支援
弊社は Microsoft 365・Azure の導入支援を本業としており、AI アバターについても、実際に API を叩いて動かしたうえで判断材料を揃えることを重視しています。本記事に書いた制約は、すべて検証の過程で確認したものです。
ご支援できるのは次のような範囲です。
- 要件との突合:データの所在・提供リージョン・開示義務といった要件に対して、Azure の AI アバターが適合するかを先に判定します
- 試作による見極め:実際の原稿で短い動画を生成し、表情や動きが許容できる水準かを目で確かめていただきます
- 他の実装方式との比較:AI アバターが最適解ではない場合もあります。音声のみ、スライド主体、実写といった選択肢も含めて比較します
- 運用設計:合成であることの開示、フィードバック窓口、原稿の管理といった、公開後に続く運用の設計までを含めて整理します
なお、カスタムアバターは前述のとおり Microsoft の限定アクセス機能であり、弊社が申請の承認を保証できるものではありません。この点は最初にお伝えしたうえで、標準アバターや他の方式も含めて現実的な着地点をご提案しています。
まとめ
Azure の Text to speech avatar は、Azure の中で音声合成からアバター生成までを完結でき、Voice Live と組み合わせればリアルタイムの対話にも載せられる、実用的な機能です。一方で、検討の入口で効いてくる制約がいくつもあります。
- 日本リージョンでは提供されていない。データは作成したリージョンで処理される
- 写真アバターは透過の指定が効かず、グリーンバックで出してクロマキーで抜く必要がある
- 写真アバターは引いても下端で切れる。画面下端に接地させる構図が前提になる
- 動きを数値で抑えられるのは写真アバターだけ。ジェスチャーを付けられるのはビデオアバターだけ
- 標準アバターは俳優契約に紐づくものがあり、提供終了の可能性がある
- カスタムアバターは限定アクセスで、Microsoft のアカウントチームと直接取引している顧客が対象
- 承認後は、合成であることの開示とフィードバック窓口の維持が継続的な義務になる
「AIアバターを作れるか」という問いに対する答えは、ほぼすべてのサービスで「作れます」です。判断を分けるのは、その先にある制約が自社の要件とぶつかるかどうかです。短い案内や受付のように用途を絞れば、現時点でも十分に実用の水準にあります。
よくあるご質問
日本リージョンに対応する予定はありますか。
2026年9月時点で、Microsoft から時期の公表はありません。対応リージョンは追加・変更されるため、検討の都度、公式のリージョン一覧で最新の状況をご確認ください。
既存のAzureリソースをそのまま使えますか。
対応リージョンに AI Services(または Speech)のリソースがあれば、そのまま利用できます。弊社も検証時は既存のリソースをそのまま使い、新規に作成する必要はありませんでした。ただしエンドポイントはリソース名ではなくカスタムサブドメインなので、実際の値を取得して使ってください。
自社の社員の顔でアバターを作れますか。
技術的にはカスタムアバターで可能ですが、限定アクセスの承認が前提です。加えて、本人が同意文を読む動画の提出と、書面による明示的な許諾が必要になります。生体情報の取り扱いにあたるため、社内規程との整合も先に確認してください。
アバターの服装や髪型を変えられますか。
変えられません。公式ドキュメントに、服装や髪型といった外見のカスタマイズはサポートしないと明記されています。複数のスタイルが必要な場合は、スタイルごとに別のアバターモデルを作ることになります。
生成した動画はどのくらい保管されますか。
ジョブの履歴は31日、または timeToLiveInHours で指定した時間(最大744時間)のいずれか短いほうで削除されます。生成物は自社側へダウンロードして保管する前提で設計してください。
AIアバターであることを視聴者に伝える必要はありますか。
カスタムアバターを使う場合は、合成であることの開示が Microsoft との契約上の義務になります。標準アバターであっても、国内のAI事業者ガイドラインは透明性を求めており、動画配信プラットフォーム側にも合成コンテンツの申告機能があります。開示する前提で設計することをお勧めします。
AIアバターの導入可否でお悩みの際は、お気軽にご相談ください。要件との突合から短い試作までを通して、実際に使えるかどうかを一緒に見極めます。お問い合わせはこちらから承っております。
関連サービス・関連コラム
- Azure AI Voice Live APIで「電話対応の自動化」を実現する
- Microsoft Foundry Agent Service とは
- AIエージェントに「権限」をどう与え、統制するか
- Azure導入支援
- ソブリンクラウドとデータ主権
まずは無料トライアルで、効果をご確認ください
「AIプライベート」は短期・低コストで試せます。帳票入力(AI-OCR)や電話受注(AI-Voice)の自動化、Azure/Microsoft 365・DXのご相談まで、お気軽にどうぞ。