Azure Content Understanding とは|生成AIで文書・音声・動画を構造的に整理する仕組み
取引先ごとに様式が違う帳票や通話の録音、動画——こうした決まった形のないデータを、あらかじめ決めた項目の業務データに変える。それを生成AIで実現するのが「Azure Content Understanding」です。
様式が決まった帳票は Azure Document Intelligence、様式の揺れが大きい文書や音声・動画は Content Understanding——Microsoftはこのように用途で使い分けるよう案内しており、すでに Document Intelligence で動いている仕組みに移行の必要はありません。
本記事では「Document Intelligence と何が違うのか」「どちらを選ぶべきか」「既存の仕組みを移行する必要はあるのか」という疑問に、Microsoftの公式情報をもとに実務目線でお答えします。前提となる Document Intelligence については「Azure AI Document Intelligenceとは」で解説しています。
目次
株式会社ロクシアシステムズは、福岡と東京を拠点に、全国のお客様へ Microsoft 365・Azure の導入支援と、AIの業務活用(AIプライベート)の支援を提供しているIT企業です。
Azure Content Understanding とは|決まった形のないデータを「項目」に沿って構造化するサービス
Azure Content Understanding は、文書・画像・音声・動画を入力すると、あらかじめ定義した項目に沿って内容を取り出し、構造化されたデータとして返すAzureのAIサービスです。2026年9月時点の正式名称は Azure Content Understanding in Foundry Tools で、Microsoftの「Foundry Tools」(旧称 Azure AI サービス)を構成するサービスの一つとして、Microsoft Foundry のリソース上で利用します。
APIバージョン 2025-11-01 で一般提供(GA)となりました。本番の業務で使うのはこのGA版です。新しい機能を先行して試せるプレビュー版(2026-06-01-preview)もありますが、SLAがなく、本番での利用は推奨されていません。
位置づけとして押さえておきたいのは、Content Understanding が Document Intelligence と競合する別製品ではない、という点です。Microsoftは Content Understanding を、Document Intelligence の高精度な文書抽出の機能と、生成AI(大規模言語モデル)による非構造・マルチモーダルなデータの処理を一つにまとめたサービスとして説明しています。
| 項目 | 内容(2026年9月時点) |
|---|---|
| 正式名称 | Azure Content Understanding in Foundry Tools |
| 提供状況 | 一般提供(GA)。APIバージョン 2025-11-01(2025年11月) |
| 扱えるデータ | 文書・画像・音声・動画 |
| 出力 | 検索やRAG向けの Markdown、定義した項目に沿った JSON |
| 抽出項目の定義 | 項目の名前と説明を書いて定義する。ラベル付けなしで始められる |
| 生成AIモデル | お客様が Microsoft Foundry にデプロイしたモデルを利用する |
| 試す場所 | Content Understanding Studio(ブラウザで読み取り結果を確認できる) |
Document Intelligence との違いと使い分け|帳票の性質で選ぶ
もっとも迷いやすいのがこの点です。Microsoftは、両者の得意分野を次のように整理しています。
| 観点 | Azure Document Intelligence | Azure Content Understanding |
|---|---|---|
| 仕組み | 文書の解析・抽出のために学習された専用モデル | 生成AI(大規模言語モデル)を組み合わせた抽出 |
| 得意な文書 | 共通の様式を持つ、構造化された帳票 | 様式の揺れが大きい文書、非構造の文書 |
| 重視される点 | 結果の一貫性、低遅延、実績のある精度 | 様式や言い回しの違いへの対応、推論が必要な項目の抽出 |
| カスタム抽出の始め方 | ラベル付けしたサンプルで学習する(ニューラルモデルは5件から) | 項目を言葉で定義し、ラベルなしで始める |
| 扱えるデータ | 文書(PDF・画像など) | 文書・画像・音声・動画 |
| オンプレミス・閉域環境 | コンテナで対応(公式の早見表では現状唯一の選択肢) | — |
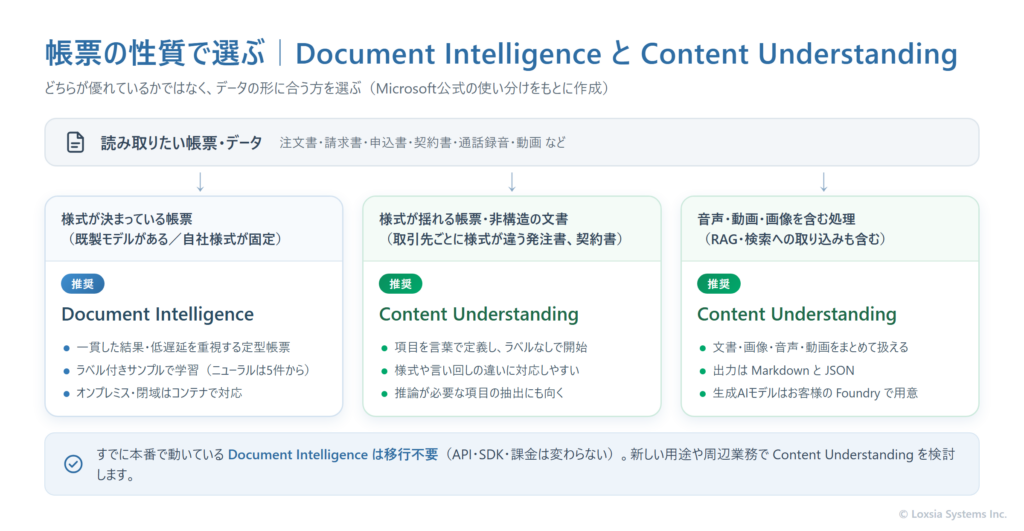
Microsoftの早見表とシナリオ別の解説から、帳票業務に関係の深いものを抜き出すと次のとおりです。
| やりたいこと | 推奨される方式 | 理由(公式の説明の要旨) |
|---|---|---|
| 文字や表のレイアウトを読み取るだけ | Content Understanding の prebuilt-read/prebuilt-layout | より低コストで、豊富なレイアウト情報を取得できる |
| 請求書・領収書など、既製モデルがある定型帳票 | Document Intelligence の事前構築済みモデル | 共通の様式を持つ帳票で高い精度 |
| 様式が固定の自社帳票を、ラベル付きで学習させる | Document Intelligence のカスタムモデル | ニューラルモデルは5件のラベル付きサンプルから学習できる |
| 取引先ごとに様式が異なる請求書・納品書・発注書 | Content Understanding のカスタムアナライザー | ラベルなしで始められ、様式や言語の違いにも対応しやすい |
| 契約書など、非構造の文書 | Content Understanding の事前構築済み(契約書)・カスタム | 推論が必要な項目の抽出に向く |
| 音声・動画・画像を含む処理、RAGの前処理 | Content Understanding | マルチモーダルに対応し、検索への取り込みにも使える |
| オンプレミス・閉域環境で動かす | Document Intelligence のコンテナ | 現状で唯一の選択肢 |
すでに Document Intelligence を本番で使っている場合について、Microsoftは「API・エンドポイント・SDK・課金は変わらず、移行は不要」と明記しています。Content Understanding は、生成AIやマルチモーダル処理、ラベルなしの抽出が役立つ新しい用途や周辺業務に向けた選択肢、という位置づけです。
弊社の見立て
選び方の基本は「どちらが優れているか」ではなく、「帳票の性質に合うのはどちらか」です。同じ業務の中でも、様式が固定の自社帳票は Document Intelligence、取引先ごとに様式が異なる注文書は Content Understanding というように、帳票ごとに方式を分けて考えると、無理のない構成になりやすくなります。
できること|文書・画像・音声・動画を業務データに変える
Content Understanding は、入力するデータの種類ごとに、次のような処理ができます。
| データ | 主にできること | 業務での使いどころ(例) |
|---|---|---|
| 文書 | 印刷・手書き文字の読み取り、段落・表(ページをまたぐ表の結合を含む)・チェックボックス・バーコードの認識、定義した項目の抽出。縦書きの行も認識する | 取引先ごとに様式が違う注文書・請求書、申込書、契約書 |
| 画像 | 画像の内容をもとにした説明文の生成や分類 | 現場写真・商品写真の分類や説明付け |
| 音声 | 話者の区別を含む文字起こし、内容の要約や項目の抽出 | 電話でのお問い合わせの記録、通話内容の要約 |
| 動画 | 文字起こし、シーンの区切りやキーフレームの抽出、内容の要約 | 研修・点検動画の要約、検索用の索引づくり |
注意したいのは、画像の中の「文字を読み取ること」が主な目的の場合です。Microsoftは、この場合は画像向けの処理ではなく、文書向けの項目抽出を使うよう案内しています。伝票や帳票を撮影した写真は、「文書」として扱うのが基本です。
出力は、検索やRAG(社内文書をAIに参照させる仕組み)に取り込みやすい Markdown と、定義した項目に沿った JSON の2種類です。後続のシステム登録には JSON、社内の検索やAIへの取り込みには Markdown、というように使い分けます。
仕組み|アナライザー・項目の定義・生成AIモデル
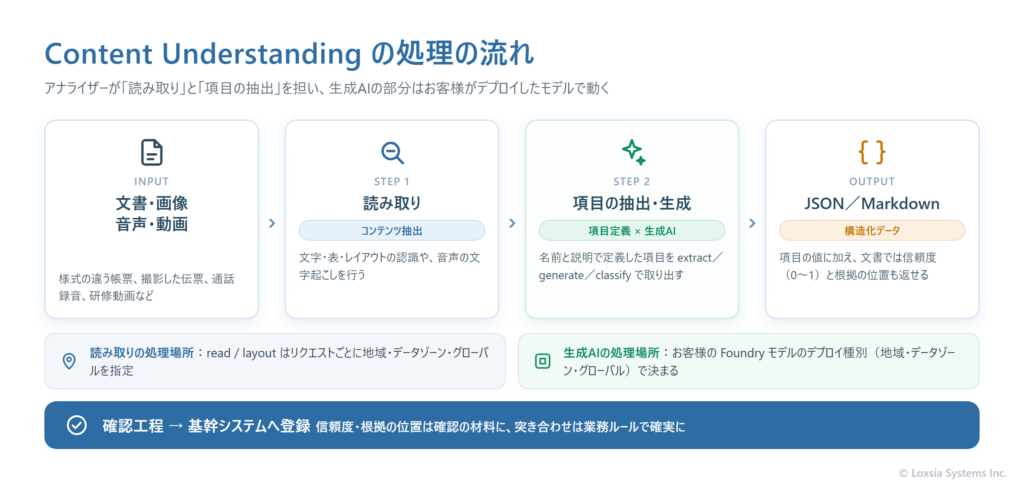
Content Understanding の処理の単位は「アナライザー」です。アナライザーには、データの種類ごとの読み取り方と、取り出したい項目の定義(フィールドスキーマ)が含まれます。全体の流れは次の図のとおりです。
事前構築済みアナライザーとカスタムアナライザー
Microsoftが用意する事前構築済みアナライザーには、文字とレイアウトを読み取る prebuilt-read/prebuilt-layout のほか、請求書・領収書・発注書・契約書といった業務文書向けや、コールセンターの通話向けのものがあります。ただし、帳票向けの多くは米国などの書式を前提にしたもので、日本固有の帳票に特化したものは用意されていません。自社の帳票に合わせる場合は、文書・画像・音声・動画の基本アナライザーをもとに、カスタムアナライザーを作ります。なおMicrosoftは、事前構築済みアナライザーの定義はAPIバージョンによって変わり得るため、本番ではコピーして使うよう推奨しています。
項目は「名前と説明」で定義する
カスタムアナライザーでは、取り出したい項目ごとに名前・型・説明を定義します。説明文はAIへの小さな指示(プロンプト)として使われるため、「帳票右上に記載された発注番号」のように、人に伝えるつもりで具体的に書くのがコツです。項目ごとの取り出し方は、次の3種類から選べます(指定しない場合は自動で選ばれます)。
| 方法 | 動き | 例 |
|---|---|---|
| 抽出(extract) | 文書に書かれている値を、そのまま取り出す(文書のみ) | 発注番号、日付、合計金額 |
| 生成(generate) | 内容をもとに、値を生成する | 備考欄の要約、依頼内容の要点 |
| 分類(classify) | あらかじめ決めた選択肢から選ぶ | 帳票の種類、お問い合わせの区分 |
日付や数値は、日本の表記(ja-JP)を含むロケールに応じて標準的な形式に正規化されて返ります。また、ラベル付けは必須ではなく、項目を定義しただけの状態から試せます。精度を高めたい場合は、Content Understanding Studio でラベル付きのサンプルを追加して改善していきます(文書のみ)。
信頼度と根拠の位置
文書では、取り出した項目ごとに0〜1の信頼度と、値の根拠になった位置(ページ・座標)を返すよう設定できます。確認画面で「帳票のどこから読んだ値か」を示したり、信頼度の低い項目を優先して確認に回したりする設計に使えます。この機能は利用者が有効にして使うもので、有効にするとAIの処理量(トークン)が増える点に注意が必要です。
生成AIモデルは、お客様の Microsoft Foundry で用意する
生成AIを使う処理には、お客様が Microsoft Foundry にデプロイしたモデル(文章を生成するモデルと、埋め込み用のモデル)が使われます。対応モデルはGPT系列で、2026年9月時点の公式ドキュメントでは GPT-5.2 が推奨されています(GPT-4.1系列は2026年10月に廃止予定と案内されています)。一方、文字とレイアウトを読み取るだけの prebuilt-read/prebuilt-layout は、生成AIモデルを必要としません。
帳票業務での使いどころと限界|確認工程の設計が肝
帳票業務で Content Understanding が活きるのは、様式を事前にそろえられない帳票です。
- 取引先ごとに様式が異なる注文書・発注書
取引先ごとにテンプレートを学習させなくても、共通の項目定義で読み取りを始められます。 - 決まった位置に値がない文書
契約書や報告書のような非構造の文書から、条件や要点を取り出せます。 - 帳票と音声が混在する業務
FAXで届く注文書(文書)と電話で受ける注文(音声)を、それぞれ同じ項目構成のデータにそろえ、後続の登録処理を共通化するといった設計が考えられます。
一方で、公式情報から読み取れる限界もあります。導入前に理解しておきたい点です。
導入前に知っておきたい限界
- 文字の読み間違いは、ラベルでは直らない
Microsoftは、ラベル付きサンプルは文字認識の誤りを修正しないと明記しています。かすれ・にじみ・崩れた手書きなど、読み取りそのものの誤りは残り得ます。 - 根拠を示せない値は、空欄になることがある
帳票上に根拠が見つからない値は返さない設計のため、項目が空欄で返る場合があります。 - 日本の帳票での精度を示す公式の数値はない
日本語は印刷文字・手書き文字とも対応言語に含まれていますが、精度の目安は公開されていません。実際の帳票で確かめる必要があります。 - 信頼度のしきい値は、自社で決める
Microsoftは、実際の文書で試験運用したうえで、業務に合ったしきい値を決めるよう案内しています。
つまり、Content Understanding を使っても、読み取った値をそのまま登録してよいかを判断する工程は残ります。AI-OCRの本当の難所は読み取りそのものではなく、確認・修正の流れと、基幹システムへの登録の設計です(詳しくは「AI-OCRとは」で解説しています)。信頼度や根拠の位置は確認を効率化する材料として使い、合計金額と明細の突き合わせやマスタとの照合といった「間違えられない確認」は、業務ルールで確実に行う構成をおすすめします。
帳票のパターンに応じて処理を振り分ける考え方は「カスタムAI-OCRの精度を継続的に高める仕組み」、信頼度を使った確認工程の組み立ては「画像PDFの図面を高精度に読み、検図まで自動化する」でも紹介しています。
料金とデータの扱いの考え方|処理場所は設計で決める
料金は「読み取り」と「生成AI」の2本立て
Content Understanding の料金は、大きく2つに分かれます。
| 区分 | 請求される先 | 課金の考え方 |
|---|---|---|
| コンテンツの抽出(読み取り) | Content Understanding | 文書はページ数、音声・動画は時間に応じた従量課金。文書は、デジタル文書の取り込み・文字の読み取り・レイアウト解析といった処理内容によって単価が分かれる |
| 生成AIによる処理 | Content Understanding と Microsoft Foundry | Content Understanding 側の処理料金に加え、デプロイしたモデルのトークン料金が Foundry 側で発生する(二重に課金されるものではない) |
同じ帳票でも、どのアナライザーを使うか、信頼度と根拠の位置を有効にするか、どのモデルを使うかによって費用は変わります。単価は改定されることがあるため、Azureの公式価格ページと料金計算ツールで、想定するページ数や時間から試算するのが確実です。
東日本リージョンで使えるか、データはどこで処理されるか
Content Understanding は、東日本(Japan East)リージョンに対応しています。保存されるデータはリソースを作成したリージョンに置かれます。入力した文書や処理途中のデータは処理が終わると削除され、処理結果は取り出しのために最大24時間保持されたのち、自動で削除されます。
一方で、処理が行われる場所は、リソースのリージョンだけでは決まりません。
| 処理 | 処理場所の決まり方 |
|---|---|
| 文字・レイアウトの読み取り(prebuilt-read/prebuilt-layout) | リクエストごとに、処理場所(日本などの地域、データゾーン、グローバル)を指定できる |
| 生成AIを使う処理 | お客様がデプロイしたモデルのデプロイ種別(地域、データゾーン、グローバル)に従う。リソースのリージョン外で処理される場合がある |
つまり、東日本リージョンにリソースを作れば、すべての処理が国内で完結するとは限りません。国内での処理が求められる業務では、読み取りの処理場所の指定と、モデルのデプロイ種別を要件に合わせて設計する必要があります。デプロイ種別やリージョンによって利用できるモデルも異なるため、処理場所の要件とモデルの選定は、あわせて検討します。
導入の進め方|実際の帳票で試してから設計する
- 対象の帳票・データを分類する
様式が固定か、揺れるか、音声や動画を含むかで分け、Document Intelligence と Content Understanding のどちらで扱うかの目安を立てます。 - 実際の帳票で試す
Content Understanding Studio で、事前構築済みアナライザーや、項目を定義したカスタムアナライザーの読み取り結果を確認します。 - 項目の定義を磨き、精度を測る
説明文の書き方の見直しやラベル付きサンプルの追加で結果を改善し、正解データと突き合わせて項目ごとの精度を測ります。 - 確認工程と処理場所を設計する
信頼度のしきい値、人が確認する画面、業務ルールによる突き合わせ、処理場所の指定とモデルのデプロイ種別を決めます。 - 本番の仕組みに組み込む
GA版のAPIやSDKで業務システムとつなぎ、利用するモデルの廃止予定や、アナライザー定義の変更にも備えた運用にします。
弊社の支援|帳票に合った方式で、読み取りから登録まで
弊社は、Azure Document Intelligence を中核に、帳票の読み取りからシステム入力までを自動化する「AI-OCRプライベート」を、お客様専用の環境で提供しています。
様式が固定の帳票と、取引先ごとに様式が異なる帳票が混在する業務では、帳票の性質に応じて Document Intelligence と Content Understanding を使い分ける構成も含めてご提案します。読み取り方式の選定に加えて、確認・修正の流れ、処理場所の設計、基幹システムへの登録までを一貫して支援します。お手元の帳票での読み取りは、無料トライアルでご確認いただけます。サービスの詳細は「AI-OCRプライベート」をご覧ください。
よくあるご質問
こちらをクリックして「よくある質問」を表示
Azure Content Understanding と Azure Document Intelligence の違いは何ですか?
Document Intelligence は、文書の解析のために学習された専用モデルで、共通の様式を持つ帳票を一貫した結果で読み取る用途に向いています。Content Understanding は生成AIを組み合わせたサービスで、様式の揺れが大きい文書や非構造の文書、音声・動画を含むデータから、定義した項目を取り出す用途に向いています。Microsoftは Content Understanding を、Document Intelligence の機能と生成AIの機能を一つにまとめたサービスとして位置づけています。
すでに Document Intelligence を使っています。Content Understanding への移行は必要ですか?
必要ありません。Microsoftは、本番で稼働している Document Intelligence のAPI・エンドポイント・SDK・課金は変わらず、移行は不要と明記しています。Content Understanding は、様式の揺れが大きい帳票や音声・動画など、新しい用途や周辺業務で検討するのが基本です。
日本語や手書きの帳票も読み取れますか?
公式の対応言語には、印刷文字・手書き文字とも日本語が含まれており、日付や数値の正規化も日本の表記に対応しています。ただし、日本の帳票での精度を示す公式の数値はなく、事前構築済みアナライザーも日本固有の帳票向けではありません。実際の帳票で試して確認することをおすすめします。弊社では、手書きの項目は確認工程を前提に扱う設計をおすすめしています。
東日本(Japan East)リージョンで使えますか? 処理は国内で行われますか?
東日本リージョンに対応しており、保存されるデータはリソースのリージョンに置かれます。ただし処理場所は、文字・レイアウトの読み取りではリクエストごとの指定によって、生成AIを使う処理ではデプロイしたモデルのデプロイ種別によって決まります。国内での処理が求められる場合は、これらを要件に合わせて設計する必要があります。
料金はどのように決まりますか?
読み取り(コンテンツの抽出)の料金と、生成AIによる処理の料金の2本立てです。読み取りは文書のページ数や音声・動画の時間に応じた従量課金で、生成AIによる処理では、Content Understanding 側の料金に加えて、デプロイしたモデルのトークン料金が Microsoft Foundry 側で発生します。単価は改定されることがあるため、Azureの公式価格ページと料金計算ツールで試算してください。
生成AIのモデルは何を使いますか?
お客様が Microsoft Foundry にデプロイしたモデルを使います。文章を生成するモデルと埋め込み用のモデルが必要で、対応モデルはGPT系列です。2026年9月時点の公式ドキュメントでは GPT-5.2 が推奨されています。対応モデルは更新されるため、導入時に最新の公式情報を確認してください。
これから帳票の自動化を始める場合、どちらから試すべきですか?
帳票の性質で決めます。様式が固定の帳票や、請求書・領収書など既製モデルがある帳票は Document Intelligence から、取引先ごとに様式が異なる帳票や非構造の文書、音声・動画を含む業務は Content Understanding から試すのが目安です。一つの業務に両方の性質の帳票が混在することも多いため、実際の帳票を並べて分類するところから始めるのが確実です。
帳票の読み取り方式の選定や、Document Intelligence・Content Understanding の使い分けについてのご相談は、お問い合わせよりお気軽にご連絡ください。お手元の帳票と業務の流れを伺い、どこから始めるべきかをご提案します。
関連サービス・関連コラム
- 関連コラム:Azure AI Document Intelligenceとは
- 関連コラム:AI-OCRとは
- 関連コラム:AI-OCRサービスの比較
- 関連コラム:カスタムAI-OCRの精度を継続的に高める仕組み
- 関連コラム:画像PDFの図面を高精度に読み、検図まで自動化する
- 関連コラム:Azure AI Vision とは
- 関連サービス:AI-OCRプライベート
- Azure導入支援
まずは無料トライアルで、効果をご確認ください
「AIプライベート」は短期・低コストで試せます。帳票入力(AI-OCR)や電話受注(AI-Voice)の自動化、Azure/Microsoft 365・DXのご相談まで、お気軽にどうぞ。