Azure AI Document Intelligenceとは|帳票をAIが読み取る仕組み・精度・導入
Azure AI Document Intelligence とは、Microsoftが提供する、帳票や文書の画像・PDFから記載内容をAIが読み取り、構造化されたデータとして抽出するクラウドサービスです。
単に文字を読み取るだけでなく、「どこに何が書かれているか」を文書の構造として理解し、そのままシステムに登録できる形で出力できる点が最大の特徴です。
本記事は、Azure AI Document Intelligence という技術基盤そのものを掘り下げる解説です。AI-OCR全体の基礎(従来OCRとの違い・できること/できないこと・導入効果の測り方・失敗する典型パターン・共有SaaSとお客様専用構築の選び方)は、親記事の AI-OCRとは|帳票の手入力をなくす仕組みと、失敗しない選び方 で解説しています。AI-OCRの導入をこれから検討される場合は、先に親記事をお読みいただくと全体像がつかめます。
(2026年9月更新)
補足:Azure AI Document Intelligence の現在の正式名称は「Azure Document Intelligence in Foundry Tools」です。本記事では、広く使われている「Azure AI Document Intelligence」の表記で解説します。
目次
株式会社ロクシアシステムズは、福岡と東京を拠点に、Azure AI Document Intelligence を中核としたAI-OCR導入支援を全国のお客様へ提供しています。本記事では、サービスの仕組み・読み取れる帳票・実際の精度と限界・導入の進め方までを、弊社が実際に構築・運用して得た知見を交えて解説します。
Azure AI Document Intelligenceとは
Azure AI Document Intelligence は、機械学習をベースとしたOCR(光学式文字認識)およびインテリジェントな文書処理サービスです。請求書・注文書・申込書・契約書といった帳票から、必要な項目だけを正確に取り出して構造化データ(JSON)として返します。
名称は過去に2度変わっています。もともとは Azure Form Recognizer という名前で提供され、その後 Azure AI Document Intelligence に改称、現在は MicrosoftのAI基盤 Azure AI Foundry の一部として Azure Document Intelligence と呼ばれています。呼び名は変わりましたが同一のサービスであり、Azureの管理画面上でリソース種別が今も FormRecognizer と表示されるのはこの経緯によるものです。旧名称で情報を探している場合も、現行のドキュメントを参照して問題ありません。
従来のOCRとの決定的な違いは、「文字起こし」ではなく「構造の理解」である点です。従来型OCRは画像を文字列に変換するところまでを担いますが、Azure AI Document Intelligence は、表・チェックボックス(選択マーク)・キーと値の対応関係といった文書構造を認識します。さらに抽出した値を「日付」「通貨」「電話番号」「住所」などの型として返すため、後続のシステム登録に必要な正規化まで自動で行われます。
(2026年9月更新)
補足:同じ Foundry Tools には、生成AIで文書・画像・音声・動画を扱う Azure Content Understanding もあります。Document Intelligence との使い分けは、Azure Content Understanding とはで解説しています。
帳票をAIが読み取る仕組み
帳票が業務システムに登録されるまでの流れは、次の4段階に整理できます。
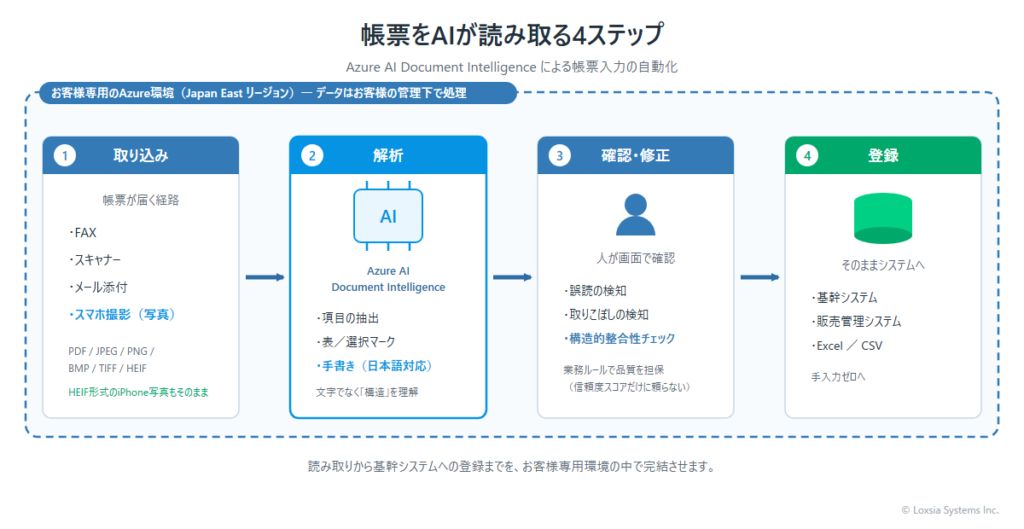
- 取り込み
FAX・スキャナー・メール添付・スマートフォンでの撮影など、さまざまな経路で届いた帳票を取り込みます。 - 解析
Azure AI Document Intelligence が帳票を解析し、あらかじめ定義した項目(取引先名・日付・品番・数量・金額・チェック欄など)を抽出します。 - 確認・修正
抽出結果を人が画面上で確認し、必要に応じて修正します。AI-OCRを実務で使ううえで、この工程の設計が精度そのものと同じくらい重要です。 - 登録
確定したデータを販売管理システムや基幹システム、Excel/CSVなどへ引き渡します。
現行の最新版は v4.0(APIバージョン 2024-11-30) で、一般提供(GA)されています。新規に構築する場合はこのバージョンを使用します。なお、旧バージョンの v3.0 は2029年3月30日、v2.1 は2027年9月15日にサポートが終了する予定です。
3種類のモデル
Azure AI Document Intelligence のモデルは、大きく3種類に分かれます。
| 種類 | 内容 | 主な用途 |
|---|---|---|
| ドキュメント分析モデル | 読み取り(Read)=印刷・手書きテキストの抽出/レイアウト(Layout)=テキスト・表・文書構造・選択マークの抽出 | 文書のデジタル化、構造の把握、カスタムモデル学習の下準備 |
| 事前構築済みモデル | Microsoftが用意した既製モデル。請求書・領収書・契約書・身分証明書・銀行取引明細書・給与明細など | 汎用的な様式の文書をすぐに読み取る |
| カスタムモデル | 自社の帳票を学習させて作る専用モデル | 企業ごとに様式が異なる注文書・申込書・管理帳票 |
日本国内の業務では注意すべき点があります。v4.0で提供される事前構築済みモデルは、米国の税務フォーム(W-2・1099・1040)や米国の住宅ローン書類に特化したものが多くを占めます。日本の実務でそのまま活用できるのは請求書・領収書・契約書・身分証明書などに限られ、企業ごとに様式が異なる注文書・申込書・自社管理帳票を読み取るには、カスタムモデルの構築が必要です。弊社が支援する案件の大半もここに該当します。
なお、名刺モデル(prebuilt-businessCard)は最新のv4.0では非推奨となり、利用するにはv3.1以前のバージョンを使う必要があります。古い記事を参考にする際はご注意ください。
カスタムモデルの2つの方式
カスタムモデルには「テンプレート」と「ニューラル」の2方式があり、帳票の性質によって選び分けます。
| 項目 | カスタムテンプレート | カスタムニューラル |
|---|---|---|
| 対応する文書構造 | テンプレート・フォーム・構造化文書 | 構造化・半構造化・非構造化文書 |
| 学習時間 | 1〜5分 | 30分〜12時間 |
| 抽出できるもの | キーと値・表・選択マーク・座標・署名 | キーと値・選択マーク・表・署名 |
| 様式のばらつき | 様式ごとにモデルが必要 | すべての様式を1モデルで扱える |
| 重複フィールド | 非対応 | 対応 |
自社様式が固定されている帳票(申込書・管理シートなど)はテンプレートが適しています。取引先ごとにレイアウトが異なる注文書のように様式が揺れる場合は、ニューラルが有力な選択肢になります。Microsoftはまずニューラルを試すことを推奨していますが、実務では学習が数分で完了しラベル位置を厳密に制御できるテンプレートが有利な場面も多く、帳票を見て判断すべきというのが弊社の見解です。
読み取れる帳票と入力形式
| 項目 | 内容 |
|---|---|
| 対象となる帳票 | 請求書・注文書・申込書・契約書・領収書・自社管理帳票 など |
| ファイル形式 | PDF/JPEG・JPG/PNG/BMP/TIFF/HEIF(読み取り・レイアウトモデルは Word・Excel・PowerPoint・HTML にも対応) |
| 手書き対応言語 | 日本語・英語・簡体字中国語・韓国語・フランス語・ドイツ語・イタリア語・スペイン語・ポルトガル語・ロシア語・タイ語・アラビア語(12言語) |
| ファイルサイズ上限 | 500MB(Standard S0) |
| ページ数上限 | 2,000ページ(PDF・TIFF/Standard S0) |
| 画像サイズ | 50×50 〜 10,000×10,000 ピクセル |
手書きの日本語に標準対応している点は、実務上きわめて大きな意味を持ちます。現場で手書きされる注文書・申込書・管理帳票は、日本の中小企業の業務に今も深く残っているためです。
また、入力形式に HEIF が含まれることも見逃せません。iPhoneでは高効率設定で撮影した写真がHEIF(HEIC)形式で保存されるため、外出先や現場でスマートフォンで撮影した帳票の写真を、変換せずそのまま読み取り対象にできます。専用のスキャナーを現場に置く必要がありません。ただし公式には「1文書につき1枚の鮮明な写真または高品質なスキャン」が推奨されており、撮影の質が精度を大きく左右します。
精度と限界
AI-OCRの導入で最も誤解が多いのが、この精度の話です。弊社が実際に構築・運用して得た知見を、率直に共有します。
活字は高精度、手書きは条件次第
印刷された活字は高精度に読み取れます。一方で手書き文字は、対応言語であっても条件によって誤認が発生します。
弊社が構築した、手書き帳票をスマートフォンで撮影して読み取るシステムでは、印字されたヘッダー項目は全サンプルで完全に抽出できました。しかし手書きの氏名・金額では、「6000」を「8000」と誤読する、1つの値が複数の断片に分割されるといった事象が確認されています。手書きを扱う場合、確認・修正の工程は省略できません。誤読を業務に流さないための確認の設計は、別記事「手書き帳票のAI-OCR|読める範囲と確認の設計」で詳しく解説しています。
サンプル5枚では実用に届かない
公式ドキュメントでは「同じ様式の文書が5つあれば学習を開始できる」とされていますが、同時に「画像の画質が低い場合は、5件より多い学習データを使うこと」も推奨されています。
弊社が5枚でベースラインモデルを構築した際も、実運用に耐える精度には届かず、10〜20枚での再学習が必要という結論に至りました。「5枚で始められる」は「5枚で実用になる」という意味ではありません。
品質は信頼度スコアより業務ルールで確かめる
弊社の実測でわかったこと
弊社の検証環境のカスタムモデル(テンプレート方式)では、項目(フィールド)単位の信頼度(confidence)が返らない事象を確認しました。旧SDK(Form Recognizer系のクライアントライブラリ)とREST API(2024-11-30)の双方で解析したところ、返却されたのは文書全体の信頼度のみで、すべての項目で信頼度は未定義でした。Microsoftの公式ドキュメントは、カスタムモデルで抽出した項目にも信頼度が付く前提で説明していますが、「現時点では、すべての項目が信頼度を返すわけではない」とも記載しています。モデルの学習時期やAPIバージョン、項目の種類によって結果が変わる可能性があるため、信頼度を品質判定に使う場合は、実際の帳票とモデルで事前に確かめることをおすすめします。
つまり、「この項目は信頼度が低いから人が確認する」という品質ゲートを、信頼度スコアだけに頼って設計するのは危ういということです。信頼度が返る場合でも、それは正しさの推定値であり、値が正しいことを保証するものではありません。
では、どう品質を担保するか。答えは業務ドメインの構造的整合性で検証することです。たとえば「明細1行に選択肢が2つ以上ある=誤読」「記入があるのにチェックが付いていない=取りこぼし」といった、その業務でしか成り立たない整合性ルールを検証ロジックとして組み込みます。
汎用のOCR製品では作り込めないこの部分こそが、実務で使えるAI-OCRと使えないAI-OCRの分かれ目です。
他のOCRとの違い
| 観点 | 従来型OCR | 汎用AI-OCRサービス(共有SaaS) | Azure AI Document Intelligence(お客様専用構築) |
|---|---|---|---|
| 読み取りの考え方 | 画像を文字に変換する | 提供元のテンプレートに当てはめる | 文書の構造として理解する |
| 自社帳票への適合 | 座標指定など固定的 | 提供元の設定範囲に依存 | 自社帳票を学習させ専用モデルを作れる |
| 手書き | 苦手 | サービスにより異なる | 日本語を含む12言語に対応 |
| データの置き場所 | 自社内 | 提供元のクラウドへ送信される | お客様のAzure環境で、選んだリージョン内で処理 |
| 後処理・基幹連携 | 別途作り込み | 提供される範囲まで | 自由に設計できる |
| 費用構造 | 買い切り・保守 | 月額(枚数課金が中心) | 従量課金+構築費 |
汎用AI-OCRサービスは手軽ですが、帳票データが提供元のクラウドへ送信されます。取引先の情報・価格・個人情報を含む帳票を扱う場合、この一点が導入の障壁になる企業は少なくありません。Azure AI Document Intelligence を自社環境に構築する方式は、この制約を構造的に解消します。
導入の5ステップ
- 対象帳票の棚卸し
どの帳票を、月に何枚、誰が入力しているかを可視化します。効果が出るのは「量が多く、様式が安定している帳票」です。 - サンプルの収集
5枚から学習可能ですが、実運用品質を狙うなら10〜20枚を集めます。ここが最も時間のかかる工程です。 - モデルの学習
項目にラベルを付けて学習させます。テンプレート方式なら1〜5分で完了します。なお、テンプレート方式のモデル学習は無料です。ニューラル方式もv4.0では10時間まで無料で学習でき、これを超える場合にのみ課金されます。 - 確認・修正画面と基幹連携の設計
前述の構造的整合性チェックを組み込み、既存システムへの連携方式を決めます。 - 本番運用と精度改善
運用で集まった実帳票を追加して再学習し、精度を継続的に高めます。
弊社の支援|AI-OCRプライベート
弊社は、Azure AI Document Intelligence を中核に、帳票の読み取りからシステム入力までを自動化する「AI-OCRプライベート」を、お客様専用の環境で提供しています。
- お客様専用環境で完結
お客様専用のAzure環境に構築し、帳票データはお客様の管理下で扱います。 - 国内リージョンで処理
東日本(Japan East)リージョンにリソースを作成し、帳票の解析と結果の一時保存を同リージョン内で行います。 - 手書き・スマホ撮影に対応
手書き帳票、現場でスマートフォンから撮影した写真も、そのまま取り込めます。 - まず無料で試せる(プルーフファースト)
実際の帳票で動くAIを無料でお試しいただけます。精度をご自身の目で確かめてから、導入をご判断いただけます。 - 基幹システムまで一気通貫
読み取りから確認・修正、基幹システムへの登録までを設計・構築します。
よくあるご質問
こちらをクリックして「よくある質問」を表示
Azure AI Document Intelligence と Azure Form Recognizer の違いは何ですか?
同じサービスです。Azure Form Recognizer が旧名称で、Azure AI Document Intelligence へ改称され、現在は Azure AI Foundry の一部として提供されています。機能が別物になったわけではありません。
手書き文字は読み取れますか?
読み取れます。日本語を含む12言語の手書きに対応しています。ただし活字と比べると誤認が発生しやすく、確認・修正の工程を前提に設計する必要があります。
スマートフォンで撮影した写真でも読み取れますか?
読み取れます。JPEG・PNGに加え、iPhoneの高効率設定で撮影される形式であるHEIFにも対応しているため、変換なしでそのまま扱えます。精度を保つため、傾き・影・解像度に配慮した撮影運用の設計をおすすめします。
読み取ったデータが外部に送信されることはありませんか?
弊社のAI-OCRプライベートでは、帳票データはお客様専用のAzure環境に作成したリソースで処理され、外部のSaaS事業者へ渡ることはありません。解析は東日本(Japan East)リージョンで行われ、Document Intelligence 側の一時保存データはMicrosoftの仕様により24時間で自動削除されます。確認画面や履歴のためのデータは、お客様専用のAzure環境内に保存します。
帳票のサンプルは何枚必要ですか?
学習の開始には同じ様式が5枚あれば可能です。ただし実運用の精度を狙うなら、弊社の検証をふまえ10〜20枚をおすすめします。公式にも、画質が低い場合は5枚より多い学習データを使うよう記載されています。
既存の販売管理システムや基幹システムに連携できますか?
可能です。CSV/API連携など、既存システムに合わせて弊社が設計・構築します。帳票を読み取るだけでなく、基幹システムへの登録までを自動化してはじめて業務が楽になります。
費用はどれくらいかかりますか?
Azure AI Document Intelligence の利用料は、モデルの種類と解析したページ数に応じた従量課金です。モデルの学習は、テンプレート方式なら無料、ニューラル方式もv4.0では毎月10時間まで無料のため、通常の構築で費用が発生するのは主に解析を実行したときです。ただし、ラベルファイルのない学習データを使うと、ラベルの自動生成にレイアウトモデルが使われ、その分の利用料がかかります。実際の総額は帳票の枚数と業務要件により変わるため、無料トライアルの段階で想定枚数から試算をお出ししています。読み取り方式ごとの単価と、総額の見積もり方は「AI-OCRの費用・料金」で解説しています。
導入のご相談・お見積り・無料トライアルのご希望は、お問い合わせよりお気軽にご連絡ください。
まずは資料で検討したいという方は、AI-OCRプライベートのサービス資料(無料ダウンロード)をご用意しています。導入イメージ・システム構成・進め方をまとめています。
関連サービス
- AI-OCR導入支援|AI-OCRプライベート
- AI-Voice導入支援|AI-Voiceプライベート
- AIエージェント導入支援(Copilot Studio)
- クラウド導入支援(Azure)
- DX支援(デジタル化戦略コンサルティング)
まずは無料トライアルで、効果をご確認ください
「AIプライベート」は短期・低コストで試せます。帳票入力(AI-OCR)や電話受注(AI-Voice)の自動化、Azure/Microsoft 365・DXのご相談まで、お気軽にどうぞ。