Azure AI Search のインデクサーを閉域で動かす|共有プライベートリンクだけでは足りない設定と、設計の制約
Azure AI Search のインデクサーは、共有プライベートリンクを承認しただけでは閉域のデータに届きません。インデクサーごとに実行環境を private に指定しておかないと、検証では成功していたインデクサーが、本番で断続的に失敗することがあります。
閉域のストレージや Azure OpenAI にインデクサーをつなぐときは、共有プライベートリンクの作成と承認に加えて、インデクサーごとの実行環境の指定、埋め込みスキルの数の上限、private に固定したときの実行時間と検索への影響までを、あわせて設計することが大切です。
Azure OpenAI や Azure AI Search をプライベート エンドポイントで閉じる基本は、Azure OpenAI・AI Searchを閉域で使うで解説しました。ここでは、その基本を押さえた方でもつまずきやすい、AI Search から外へ出ていく通信(インデクサーの接続)を扱います。
目次
株式会社ロクシアシステムズは、福岡と東京を拠点に、全国のお客様へ Microsoft 365・Azure の導入支援と、AIの業務活用(AIプライベート)の支援を提供しているIT企業です。
インデクサーはどこで動いているのか:2つの実行環境
AI Search のインデクサーは、ストレージやデータベースからデータを読み、必要ならスキルセットで加工して、インデックスに書き込みます。このとき AI Search は、外のリソースへ自分から接続しにいきます。閉域の設計で問題になるのは、この外向きの通信です。
Learn によると、インデクサーの処理は次の2つの実行環境のどちらかで動きます。
| 実行環境 | どういう環境か | プライベート エンドポイントを通れるか |
|---|---|---|
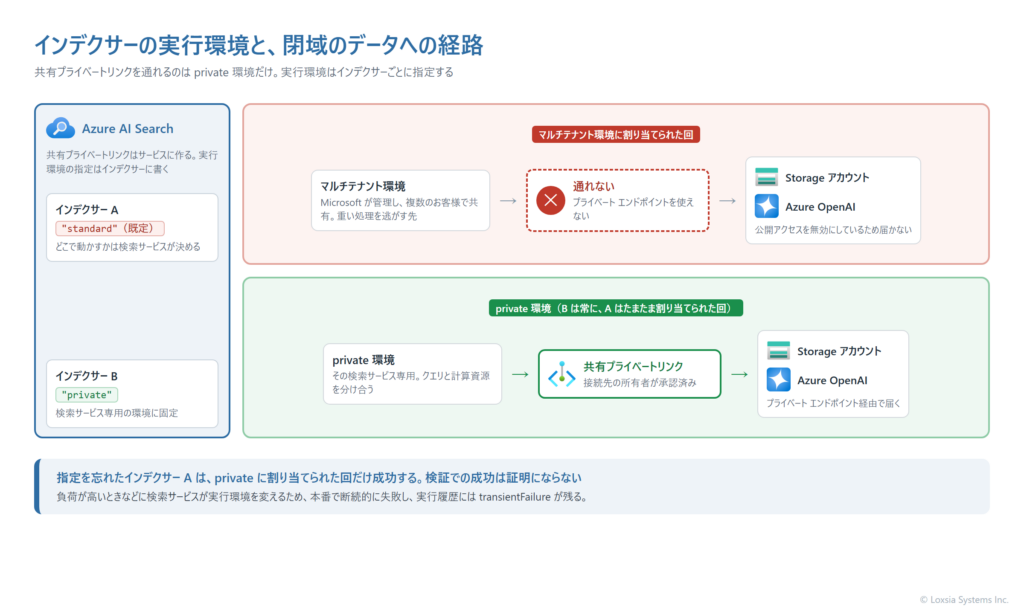
| private | その検索サービス専用の環境。インデックスの作成やクエリと、同じ計算資源を分け合う | 通れる。共有プライベートリンクを使えるのはこの環境だけ |
| マルチテナント | Microsoft が管理し、複数のお客様で共有する環境。スキルセットなど重い処理を逃がすために使われ、追加の費用はかからない | 通れない。お客様が管理するネットワークの設定は及ばない |
どちらで動かすかは、インデクサーの定義にある executionEnvironment で決まります。値は standard と private の2つで、何も書かなければ standard です。standard は「どこで動かすかは検索サービスが決める」という意味で、Learn はスキルセットの多くをできる限りマルチテナント環境で動かすと説明しています。
先に答えておきたい2つの疑問
サービス全体で一度だけ private にできないのか
できません。Learn は、この設定は検索サービスではなくインデクサーの単位であり、すべてのインデクサーをプライベート エンドポイント経由で接続したいなら、1つずつ設定する必要があると明記しています。共有プライベートリンクはサービスに作るのに、実行環境の指定はインデクサーに書く、という非対称が、設定漏れの原因になります。
既定が standard なのにも理由があります。マルチテナント環境は、重い処理を検索サービスの外へ逃がし、クエリに使う資源を守るための仕組みです。REST API のリファレンスも、private は共有プライベートリンク経由で安全に接続する必要があるときだけ指定するよう書いています。閉域のデータにつなぐインデクサーだけを private にする、というのが本来の使い方です。
共有プライベートリンクを使わず、IPファイアウォールで足りないのか
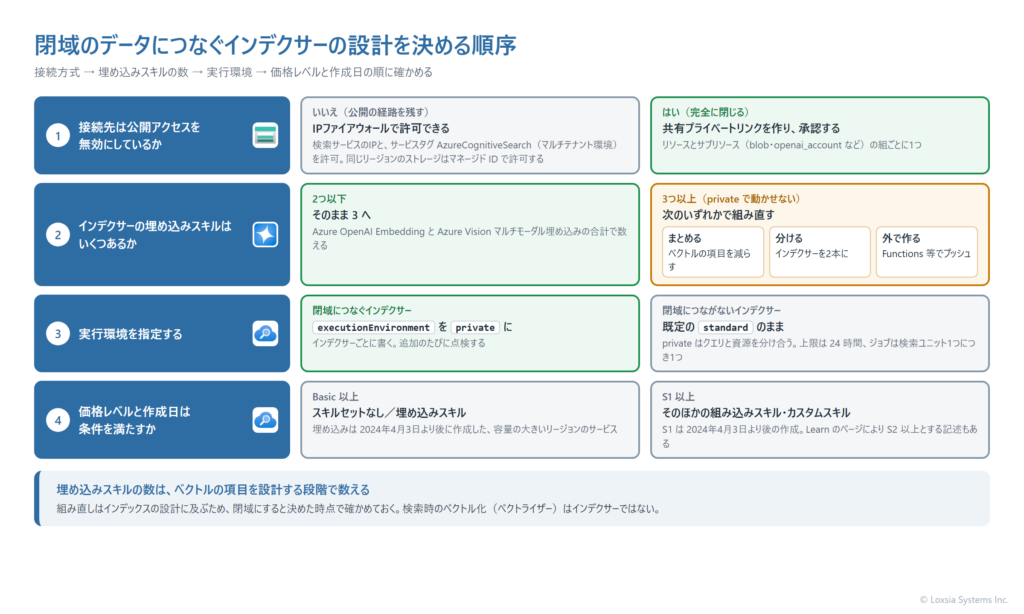
接続先が公開のエンドポイントを残しているなら、IPファイアウォールで許可する方法もあります。この場合は、検索サービス自身のIPアドレス(private 環境)に加えて、マルチテナント環境のIPアドレス範囲をサービスタグ AzureCognitiveSearch で許可します。IPファイアウォールは無料で、共有プライベートリンクは Azure Private Link の料金がかかります。
ただし、同じリージョンのストレージは、IPアドレスによる制限では AI Search からの接続を許可できません。この場合は、信頼されたサービスの例外か、リソース インスタンスの規則で、検索サービスのシステム割り当てマネージド ID を許可します。接続先の公開アクセスを無効にして完全に閉じているなら、Learn のとおり、選択肢は共有プライベートリンクだけです。
共有プライベートリンクを通す手順
共有プライベートリンクは、AI Search の側から作る外向きのプライベート エンドポイントです。プライベート エンドポイントそのものは Microsoft が管理する環境に作られ、お客様の仮想ネットワークには現れません。手順は次の4段です。
- 作成:検索サービスの[ネットワーク]の[共有プライベート アクセス]から、接続先のリソースとサブリソース(グループ ID)を指定して作る。作成には数分かかる
- 承認:接続先のリソースの[ネットワーク]で、保留中のプライベート エンドポイント接続を承認する。承認は接続先の所有者が明示的に行う
- 実行環境の指定:閉域のリソースにつなぐインデクサーの
executionEnvironmentをprivateにする - 確認:共有プライベートリンクの状態が「プロビジョニング=Succeeded」かつ「接続=Approved」であることを確かめ、インデクサーを実行する
サブリソースは接続先ごとに決まっています。Blob Storage なら blob、Azure OpenAI なら openai_account です。共有プライベートリンクは「リソースとサブリソースの組」ごとに1つしか作れず、同じストレージでも Blob と Table を使うなら、それぞれに作ります。
3段目の実行環境の指定は、インデクサーの定義の parameters.configuration に書きます。既存のインデクサーも、定義を更新すれば変えられます。
{
  "name": "contracts-indexer",
  "dataSourceName": "contracts-blob",
  "targetIndexName": "contracts-index",
  "skillsetName": "contracts-skillset",
  "parameters": {
    "configuration": {
      "executionEnvironment": "private"
    }
  }
}
データソースの接続文字列は、共有プライベートリンクを使っても変わりません。いったん共有プライベートリンクを作ると、検索サービスはそのリソースへのインデクサーの接続に必ずそれを使い、公開の経路へ切り替えることはできません。
同じリージョンのストレージは、作るかどうかの判断が逆になる
Learn によると、ストレージと AI Search が同じリージョンにある場合、ストレージへの接続は Microsoft のバックボーンを通るため、共有プライベートリンクは本来は不要です。ただし、ストレージの側にすでにプライベート エンドポイントを設定しているなら、共有プライベートリンクも作らないと、ストレージの側で接続を拒否されます。閉域の構成では、たいていこちらに当たります。
検証では通って、本番で失敗する仕組み
実行環境の指定を忘れても、インデクサーが毎回失敗するとは限りません。これが、この設定がすり抜けやすい理由です。
Learn のトラブルシューティングには、次の趣旨の記載があります。インデクサーが常に、あるいは断続的に失敗するなら executionEnvironment を確かめること。この設定をしていないのに過去の実行が成功していたのは、検索サービスが自分の判断で private 環境を使っていたためである。負荷が高いときは、検索サービスが処理をマルチテナント環境から移すことがある。
つまり standard のままのインデクサーは、たまたま private 環境に割り当てられた回だけ、共有プライベートリンクを通って成功します。文書の少ない検証環境で何度か成功したことは、設定が正しいことの証明になりません。本番で文書の量やスキルの処理が増え、マルチテナント環境に割り当てられた回に失敗します。
失敗はネットワークの問題に見えない
Learn によると、プライベート エンドポイントが未承認の場合や、インデクサーがプライベート エンドポイントを使わなかった場合、実行履歴には transientFailure のエラーが残ります。「一時的な失敗」という名前のため、再実行で直る問題に見えがちです。インデクサーを作るときに「データソースの資格情報が無効」と出る場合も、Learn はまず共有プライベートリンクの承認の状態を確かめるよう案内しています。
弊社では、閉域のリソースにつなぐインデクサーを作るときは、定義に executionEnvironment が private で入っているかを、作成の手順と設計書の両方で確かめる項目にしています。インデクサーの定義をコードで管理していれば、この値の有無を機械的に点検できます。
埋め込みスキル3つの壁
private を指定すれば必ず閉域でつながる、というわけでもありません。Learn は、private 環境の負荷を抑えるため、Azure OpenAI Embedding スキルまたは Azure Vision のマルチモーダル埋め込みスキルを2つより多く持つインデクサーは、この環境で動かせないとしています。サービスの上限の一覧には、こうしたインデクサーでは非公開の接続も使えないと書かれています。
上限は「2つより多く」なので、埋め込みスキルが3つになった時点で当たります。ぶつかりやすいのは、ベクトルの項目を用途ごとに分けて作る設計です。たとえば、タイトル・本文の分割・画像のそれぞれに埋め込みを作ると、それだけで3つになります。
この上限はインデクサーの単位で書かれています。弊社は、ベクトルの項目を設計する段階で埋め込みスキルの数を数え、3つ以上になるなら次のいずれかで組み直すことを検討します。
| 組み直し方 | 考え方 | 代わりに受け入れること |
|---|---|---|
| 埋め込みをまとめる | タイトルと本文を連結してから1回で埋め込むなど、ベクトルの項目そのものを減らす | 項目ごとに重みを変える検索ができなくなる。検索の質を評価し直す |
| インデクサーを分ける | 同じデータを読むインデクサーを2本に分け、それぞれ2つ以下の埋め込みスキルで同じインデックスの別の項目へ書き込む | 文書を2回読むため、処理時間と埋め込みの料金が増える。2本の実行のずれを運用で吸収する |
| インデクサーの外でベクトル化する | 仮想ネットワークの中の Azure Functions などで埋め込みを作り、インデックスへ直接書き込む(プッシュ) | 統合ベクトル化の手軽さを手放し、取り込みの処理を自分で作って運用する |
なお、この上限はインデクサーに対するものです。検索のときに問い合わせの文をベクトルにするベクトライザーは、インデクサーではありません。Learn は、検索時のベクトル化で Azure OpenAI へ接続する場合も、共有プライベートリンクを使う場面として挙げています。
private に固定すると変わること
private 環境は、閉域のための「追加の性能」ではありません。検索サービス自身の計算資源で動くため、次の点が変わります。
| 項目 | private 環境 | マルチテナント環境 |
|---|---|---|
| 1回の実行の上限時間 | 24時間 | 2時間 |
| 同時に動かせる数 | 検索ユニット1つにつき、インデクサーのジョブ1つ | 決まった上限は無い(需要に応じて処理能力が足される) |
| 検索への影響 | インデックスの作成とクエリが資源を分け合うため、取り込みの量が多いと検索の応答が遅くなることがある | 検索サービスの資源を使わない |
上限時間が延びるのは利点ですが、裏を返せば、大量の文書の取り込みが長時間にわたって検索の資源を使い続けるということです。弊社は、初回の一括取り込みは利用の少ない時間帯に行い、日々の差分の取り込みは変更の検出とスケジュール実行で小さく保つようにしています。同時に動かしたいインデクサーが多いなら、レプリカを増やして検索ユニットを確保します。
もう1点、デバッグ セッションは共有プライベートリンクに対応していません。スキルセットの動きを画面で追いかける機能が閉域の構成では使えないため、スキルの検証は、閉じる前の検証環境で済ませておくのが現実的です。
価格レベルとサービスの作成日の条件
共有プライベートリンクは Free レベルでは使えず、何をつなぐかによって必要な価格レベルが変わります。Learn のサービスの上限の一覧では、次のように整理されています。
| インデクサーの中身 | 価格レベル | そのほかの条件 |
|---|---|---|
| スキルセットなし(データの読み込みだけ) | Basic 以上 | 特になし |
| 埋め込みスキル(統合ベクトル化) | Basic 以上 | 2024年4月3日より後に作成した、容量の大きいリージョンのサービス |
| そのほかの組み込みスキル・カスタムスキル | S1 以上 | S1 は2024年4月3日より後に作成したサービス |
注意したいのは、Learn のページによって記述が異なる点です。上限の一覧と共有プライベートリンクの手順のページは、スキルセットを使う場合を S1 以上としています。一方、インデクサーの外向き通信を説明するページには、スキルを使うインデックス作成は S2 以上とする記述があります。設計の際は上限の一覧を基準にしつつ、使うサービスの価格レベルと作成日を確かめてから構成を決めます。
作れる共有プライベートリンクの数にも、価格レベルごとの上限があります。Basic は接続先の種類(グループ ID)が4種類までで、S1 は7種類までです。ストレージの Blob と Table、Azure OpenAI、Key Vault のように接続先を重ねていくと、Basic では早い段階で上限に近づきます。価格レベルを下げる変更は、共有プライベートリンクの数が変更先の上限を超えていると行えません。
この記事の要点
実行環境
- インデクサーは private とマルチテナントの2つの環境で動く。プライベート エンドポイントを通れるのは private だけ
executionEnvironmentはインデクサーごとの設定で、既定はstandard。サービス全体の設定は無い
すり抜ける理由
- 指定を忘れても、検索サービスが private に割り当てた回は成功する。検証での成功は証明にならない
- 失敗は
transientFailureとして残り、ネットワークの問題に見えにくい
設計の制約
- 埋め込みスキルが3つ以上のインデクサーは private で動かせない。まとめる・分ける・外でベクトル化するのいずれかで組み直す
- private は上限24時間だが、検索と資源を分け合う。取り込みの時間帯と検索ユニットを設計する
- 価格レベルとサービスの作成日に条件がある。Learn のページ間で記述が異なるため、上限の一覧を基準に確かめる
弊社の支援
弊社は、お客様専用のAI基盤を Azure 上に構築し、運用まで支援しています。Azure OpenAI と Azure AI Search を閉域で組み合わせる構成では、プライベート エンドポイントによる受け口の設計に加えて、この記事で扱ったインデクサーの外向きの接続まで含めて設計しています。
すでに AI Search を使っていて、データソースを閉域に移したい場合も、インデクサーとスキルセットの棚卸し、埋め込みスキルの数の確認、価格レベルとサービスの作成日の確認、共有プライベートリンクの作成と承認の手順づくりまで、段階的に進める支援を行っています。
よくあるご質問
こちらをクリックして「よくある質問」を表示
共有プライベートリンクを承認したのに、インデクサーが失敗するのはなぜですか?
インデクサーの executionEnvironment が private になっているかを確かめてください。既定の standard のままだと、マルチテナント環境に割り当てられた回はプライベート エンドポイントを通れず失敗します。過去に成功していても、検索サービスがたまたま private 環境を使っていただけの可能性があります。
executionEnvironment は検索サービス全体で設定できますか?
できません。インデクサーごとの設定です。閉域のリソースにつなぐインデクサーを追加するたびに、定義に private を書く必要があります。
埋め込みスキルはいくつまでなら private 環境で動かせますか?
Azure OpenAI Embedding スキルと Azure Vision のマルチモーダル埋め込みスキルは、1つのインデクサーで2つまでです。3つ以上になると private 環境で動かせず、非公開の接続も使えません。
すべてのインデクサーを private にしておけば安全ですか?
閉域のリソースにつながないインデクサーまで private にする必要はありません。private 環境はクエリと同じ計算資源を使うため、取り込みが多いと検索の応答に影響することがあります。Microsoft も既定の standard を推奨値としています。
ストレージと AI Search が同じリージョンでも、共有プライベートリンクは必要ですか?
同じリージョンの接続は Microsoft のバックボーンを通るため、本来は不要です。ただし、ストレージの側にプライベート エンドポイントを設定している場合は、共有プライベートリンクも作らないとストレージの側で接続を拒否されます。
Basic レベルでも、閉域の Azure OpenAI で統合ベクトル化を使えますか?
Learn の上限の一覧では、2024年4月3日より後に作成した、容量の大きいリージョンの Basic のサービスであれば、埋め込みモデルへの非公開の接続に対応しています。作成日が古いサービスは対象外のため、サービスの作成日を確かめてください。
Azure AI Search を閉域のデータにつなぎたい、すでに作ったインデクサーが断続的に失敗する、というご相談を承っています。現在のインデクサーとスキルセットの構成、データソースの置き場所をお聞かせいただければ、実行環境と接続の方式の設計から、価格レベルの確認まで、進め方をご提案します。お問い合わせよりお気軽にご相談ください。
関連サービス・関連コラム
- Azure OpenAI・AI Searchを閉域で使う|Private Endpointと仮想ネットワークの設計
- クラウド導入支援(Azure)|アセスメントから移行・運用まで一気通貫で伴走
- 社内文書をAIエージェントで活かす|RAGの肝は権限と出典
- Azureの構成をBicepで管理するときの落とし穴|手作業の設定が消える理由と、本番に適用する前の確認
- ソブリンクラウドとは|データ主権の基本と、Microsoftソブリンクラウドの3つのモデル
まずは無料トライアルで、効果をご確認ください
「AIプライベート」は短期・低コストで試せます。帳票入力(AI-OCR)・電話対応(AI-Voice)・計画づくり(AI-Enhance)の自動化から、クラウド(Azure・Microsoft 365)・DXのご相談まで、お気軽にどうぞ。